一个付费用户清理磁盘时发现,自己的商业项目被ZCode打包成了加密快照,悄悄尝试上传了564次。
9月18日以前,ferstar还在技术群里向别人推荐智谱的ZCode。不到半天后,他成了那个把ZCode推上风口浪尖的人。
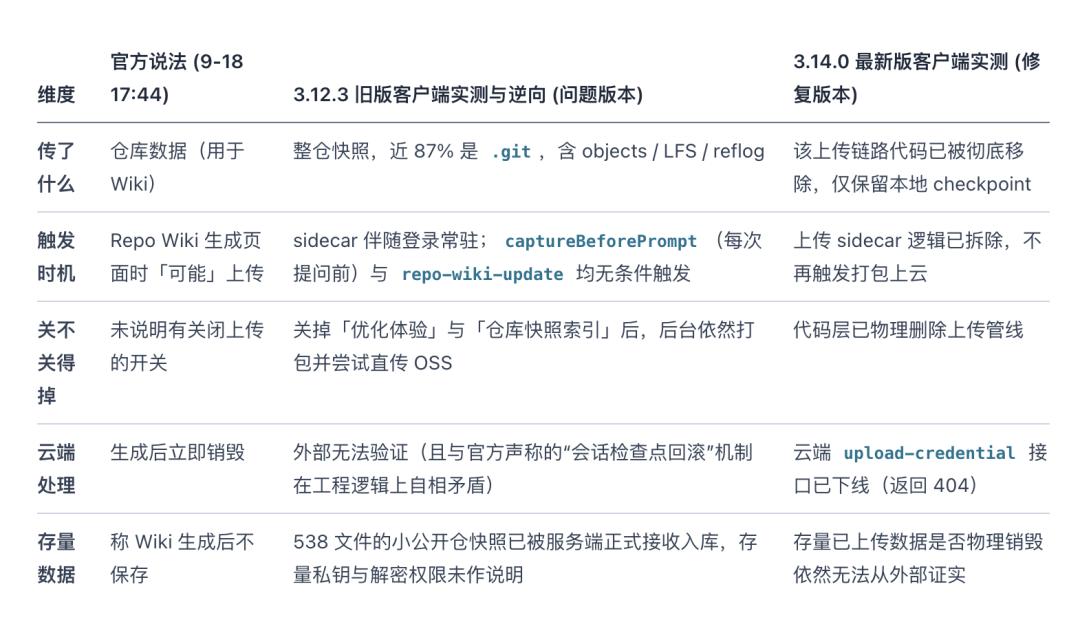
他在清理一台256GB MacBook Air的磁盘空间时发现,~/.zcode目录占用了700多MB。继续往下查,找到了一份313MB的加密文件,以及一份状态记录:ZCode扫描了他正在使用的商业项目,将345MB内容打包成全量快照,并尝试上传564次。那份313MB文件最终没有上传成功,但他换了一个小型公开仓库测试,一份包含538个文件、压缩加密后约15KB的快照,被服务器成功接收。
他继续拆解ZCode客户端。按照其公布的技术分析,旧版ZCode生成的快照不只是用户正在编辑的几段代码,还可能包括.git历史、LFS缓存、reflog以及部分配置。在他检查的一份42411个文件的快照清单中,.git相关内容占到了86.6%。
当天,ferstar把调查过程发到了网上,标题很直接:《扒一扒ZCode静默上传全量Git历史的骚操作》。
事情从这里失控。开发者开始检查自己的电脑,有人抓包,有人翻日志,有人卸载ZCode。企业用户也加入进来,开始检查自己的私有仓库究竟发生过什么。
据《中国新闻周刊》报道,近400名开发者已经进入多个维权群。企业开始固定证据、发函追责,一些个人开发者则要求退款。维权群里的人诉求并不完全一样。有人只想退款,有人想知道自己的代码究竟有没有上传成功。企业用户担心的则是另一件事:商业源码、Git历史、服务器凭据以及工程配置等敏感信息,是否曾经在不知情的情况下离开企业内部。
一家企业用户涉及9个私有仓库和4个已上线项目,相关代码及服务器凭据曾被打包上传,公司法务已开始固定证据并向智谱发函。另一家公司太原承明科技涉及6个工作区,最大的一个数据量达到410MB,公司做的是企业办公系统,项目里既有自研引擎也涉及知识产权。压力沿着业务链条传了过来——他们需要向自己的客户解释,那些原本应该留在企业内部的数据,究竟有没有离开过。
智谱的第一轮处理来得很快。9月18日当天公开致歉,将问题归因于代码库索引相关功能存在设计疏漏。按照智谱的解释,Repo Wiki需要在云端生成页面,因此可能触发仓库数据上传,相关数据在Wiki生成后会立即销毁。真正引发争议的是,这项功能上线初期被默认开启。
但问题很快从ZCode以后还会不会上传,转向了另一件更难回答的事:过去已经发生了什么。
智谱的整改随之加码。修复客户端之后,引入中国信通院、绿盟科技等第三方机构参与检查;随后宣布开源ZCode,把客户端代码交给社区监督;此后又宣布MaaS平台上线数据内容不留存等措施。从9月18日到21日,三天时间里,智谱的应对从一次客户端更新,扩展到第三方检查、产品开源以及公司层面的数据政策调整。
从目前公开的信息看,最初引发争议的技术链路已经被切断。但这只能回答现在。对于已经使用过旧版本ZCode的开发者和企业,更难回答的是过去:哪些账户曾经触发上传,哪些数据真正到达过服务器,保存过多长时间,是否存在访问记录,企业能否获得与自己账户对应的完整处理记录。
近400人,对于一家互联网公司来说并不是一个很大的用户数字。但放在智谱身上,却有另一层意义。他们中的很多人,恰好属于过去一年大模型公司争夺最激烈的一群用户:开发者。
随着基础模型价格不断下降,编程正在成为大模型公司寻找高频付费场景的重要入口。模型厂商不再满足于提供一个API,而是开始进入IDE、读取代码库、调用终端,让模型逐渐参与完整的软件开发流程。智谱也没有缺席,从GLM模型的代码能力到Coding Plan再到ZCode,持续把产品往开发者的日常工作里推进。
一个开发者的价值不只是一份订阅收入。个人开发者可能是API的使用者,创业公司的工程师可能影响团队选择哪一个模型,到了更大的企业,技术人员还可能参与模型、云服务乃至Agent产品的采购和技术评估。
这是大模型公司为什么愿意花大量资源争夺开发者,也是这次近400人维权真正麻烦的地方。其中一些人原本已经完成了最困难的一步:他们愿意付费,也愿意把真实项目放进ZCode。现在,智谱需要重新说服他们。
而且这不是今年第一次出现类似的开发者摩擦。今年2月,GLM-5上线之后,Coding Plan曾因套餐规则、模型灰度和老用户升级机制引发争议。那次争议主要围绕套餐和使用权益。到了9月,争议进入了代码和数据。
对智谱而言,更难处理的问题已经出现了。过去,它需要说服开发者把代码交给AI。现在,它还需要说服他们,下一次依然可以这么做。