通往超级智能的隐秘关卡,可能被打通了。
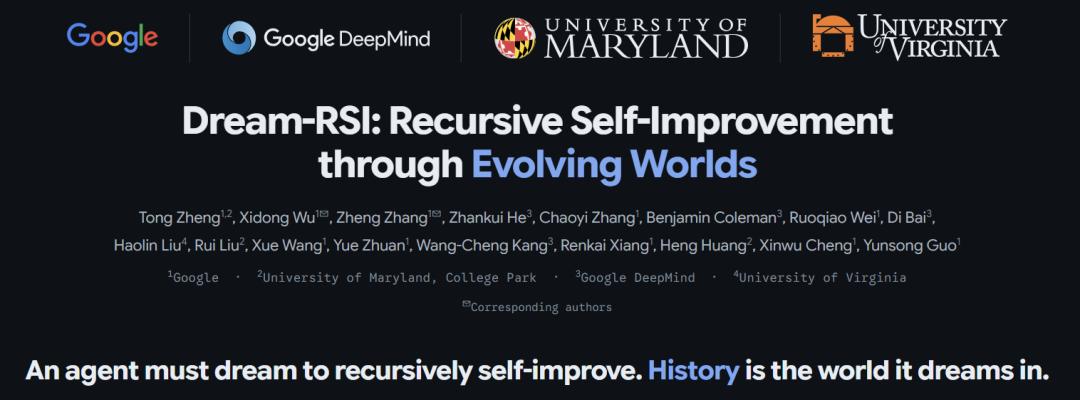
9月17日,谷歌联合Google DeepMind、马里兰大学及弗吉尼亚大学发表了一篇重磅论文,展示了一条完全不同的递归自我改进路线:AI的自我进化,可以靠做梦实现。
论文一挂上arXiv,X上先炸了。有网友高呼:谷歌可能刚刚破解了递归自我改进。
Dream-RSI要解决的是整个进化搜索领域最卡脖子的一环。以AlphaEvolve为代表的系统早已证明,让编码智能体跑进化搜索能发现人类没找到的算法。但它们有一个死穴:探索策略全靠人手写死。哪个分支该多分配算力,哪个分支该尽早剪掉,全靠工程师预先定好。搜索空间一大,固定策略就会把算力砸进死胡同,而且不长记性。
那让策略自己进化行不行?理论上行,但问题出在评估成本上。评估一段候选代码,跑一次就知道好坏。而评估一套探索策略,需要让它带着智能体从头跑完几百上千轮,才能给这套策略打分。每改一版策略,就要重跑一遍整个发现过程,等几天出一个分数,没人耗得起。
Dream-RSI的解法是:跑过的过程存下来,评估新策略时不再重跑,直接拿旧过程回放。
具体来说,它把“干活”和“决定怎么干”拆成了两层。底层是负责执行的发现智能体,由Gemini 3.1 Pro或3.7 Flash驱动,每次接过一个工作区,改出一版新候选代码,交由评估器打分。顶层是轻量的编排层,里面装着探索策略,决定每一轮从哪个节点继续、一次开多少个并行尝试、何时止损。底层模型不动,自我进化的对象只有这段策略代码。
每一次真实探索的结果都会存进一棵“发现树”。根节点是初始工作区,每个子节点记着一次尝试的完整现场,包括文件系统快照、生成的产物、评估诊断和得分。这棵树,就是模拟器。
策略要迭代时,不用再去真实环境跑代码,直接在长好的树上重走一遍历史就行。整个评估过程不调用一次模型,不跑一行代码,只读历史。论文把这种机制叫做“做梦”——就像棋手复盘,不需要重新摆盘再下一遍,翻棋谱就够了。
论文在三个领域进行了实测。
算法工程领域,任务是Lasso正则化路径求解。这是高维统计里的老难题,要求在保证数值正确的前提下把整条路径算得尽可能快。用Gemini 3.1 Pro跑Dream-RSI,只调用了317次,就把求解器的平均运行时间从3587.1毫秒降到了2931.0毫秒。相比之下,同一个模型换成固定策略,要调用550次才能到这个水平。基线SimpleTES为了拿到差不多的结果,一共生成了51200次。
数学优化领域,在和差问题、圆装填和自相关不等式三个极耗算力的离散和几何优化问题中,Dream-RSI在1000代以内就达到或超越了极强的基线性能,相比需要51200代的基线,节省了超过50倍的计算预算。
GPU内核工程是谷歌自己最在乎的地盘。VGG16和LayerNorm比的是省多少,把内核优化到和固定探索同样的性能,Dream-RSI需要的生成次数分别只有对方的1/2.43和1/1.79。ConvDiv和ConvMax比的是强多少,给两边同样的预算,Dream-RSI优化出的内核性能分别是固定探索的2.09倍和1.44倍。
论文中有一个非常反直觉的实验。研究人员尝试了“经验总结法”,让大模型把历史总结成高层指导意见,去指导下一轮的探索。结果令人大跌眼镜:注入了高层次经验总结的智能体,在探索表现上不仅没有提升,反而显著差于没有任何指导的原始基线。
原因在于,一旦将经验生硬地抽象为高层原则,它们立刻就会转化为AI的认知偏见,过度约束AI的搜索空间,扼杀了探索的多样性。相反,Dream-RSI的做梦机制不提供任何空洞真理,它直接让新策略去碰撞具体的历史树,在微观的并行控制、分支优先级和提早停止规则上进行代码级优化。这种方式保持了探索空间的开放和多样性,反而远胜于前者。
论文一作Tong Zheng是马里兰大学二年级博士生,今年夏天才以学生研究员的身份进入谷歌。2021年本科毕业于东北大学,2024年进入马里兰大学读博,师从黄恒教授。Dream-RSI正是他2026年夏天在谷歌实习时的产物。17人的作者团里,通讯作者在谷歌,DeepMind一侧也有资深研究员署名。一个暑期实习生挂一作,身后一群资深研究员署名,谷歌内部对这条路线的重视程度不言而喻。
此前,谷歌产品负责人曾透露,谷歌正在死盯前沿,并且已经看到了RSI的早期迹象。他拿Gemini 3.5到3.8大约每三到四周一更当证据。
过去十年,行业里谈起RSI,大家想到的总是AI自动修改自己的权重,训出下一代神明。但Dream-RSI展示了另一种可能性:模型权重不一定要先变,它可以通过自我重写外围的Harness,来让自己变得强大。
正如论文结尾所说:智能体必须学会做梦才能递归自我改进,而历史,就是它做梦时所处的整个世界。