过去两年,说起大模型价格屠夫,没人会想到Claude。
DeepSeek把百万tokens的价格打到几毛钱,逼着国内厂商一轮轮跟降。Claude则一直站在价格表的另一头,上一代Haiku 4.5每百万tokens输入1美元、输出5美元,在开发者眼里属于好用但不便宜的那一档。
10月8日凌晨,位置换过来了。
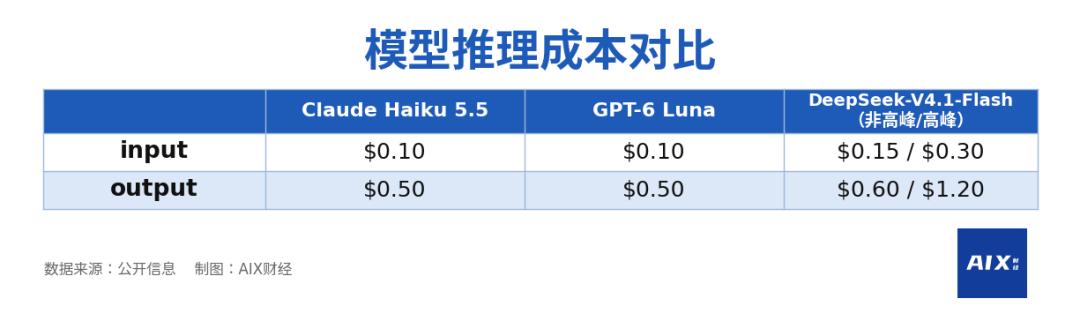
Anthropic推出轻量级模型Claude Haiku 5.5,10万tokens以内的请求每百万tokens输入0.10美元、输出0.50美元,单价只有上一代的十分之一,甚至比国内同为小模型的DeepSeek-V4.1-Flash还便宜。几乎同一时间,OpenAI宣布GPT-6全量上线,付费用户可用GPT-6 Sol,免费用户也能用上GPT-6 Luna。有网友调侃,OpenAI这是要变豆包了。
一家降到地板价,一家直接免费。海外两大巨头同时对价格动了手。
本轮价格战的重心集中在小模型身上。旗舰模型承担品牌与技术上限,定价不宜大改。小模型以有限推理成本承接高并发、轻量化任务,是争夺开发者的入口,最适合打价格战。
API方面,Claude Haiku 5.5与GPT-6 Luna同价:输入在10万以内,每百万tokens输入0.10美元、输出0.50美元。横向对比DeepSeek-V4.1-Flash,两家海外厂商在输入与输出端均价格更低。GPT-6 Luna更进一步,已被下放至ChatGPT免费层,C端用户零成本使用。
Haiku 5.5的低价有一个前提,每次发送内容不超过10万tokens。超过这条线,价格涨为原来的五倍。DeepSeek则是一百万tokens容量内统一计价。如果是轻度使用,随手问几次,Claude是便宜的。如果是重度复用,把文档当知识库反复查,DeepSeek的缓存价更有优势。
同一张价格表上,一家公司最便宜和最贵的模型,跨度巨大。OpenAI的GPT-6最贵档输入10美元,比Luna贵出百倍。Anthropic旗舰Fable 5.1输入也是10美元。0.1美元与10美元之间,卖的是不同的东西。
Anthropic的算盘很清楚。小模型这一档大概率微利或保本,但它不是亏钱引流的工具,而是整个商业生态的流量引擎。单次调用可以不赚钱,但只要调用量足够大、开发者足够多,用户就留在这个生态里,后面订阅、长文、企业服务这些更贵的收入才有机会发生。同一天,Anthropic还宣布Sonnet 5.5的缓存读取价从0.20美元砍至0.10美元,这一刀砍的是Claude Code等Agent应用中占比最大的那块账单。
OpenAI的账算法不同。免费用户拿到的是与旗舰同代发布的Luna,但免费层有次数限制,跑的又是小模型,成本压在低位。同时Luna API照收0.10美元的输入价,说明免费只限于C端,免费用户消耗的算力,可以记在获客成本里。
在国内,影响有限。多位从业者表示,DeepSeek在国内的地位短时间内不会被动摇,原因有三点:中文语境的优势;Claude在中国境内未提供服务,接入不稳定;国内企业大量需求是私有化部署与微调定制,这是闭源模型进不来的市场。
但在海外,压力是真的。Haiku 5.5会分流一部分原本倾向DeepSeek的开发者。不过海外同样存在大量私有化部署与定制化需求,开源生态能承接这部分需求,这是闭源API给不了的护城河。
接下来怎么接?从业者的答案类似:拼价格意义不大,更重要的是补结构。一方面是补分层,建立旗舰加小模型加免费端的三层结构。另一方面是放大开源,闭源低价不可避免,但开源生态、私有化部署、定制化服务,是国内厂商手里唯一不依赖裸价的牌。
海外厂商敢把0.1美元当门槛,是因为门槛后面还有订阅、缓存、工具与企业服务这几份收入。如今小模型变成入口,token差价不再是利润主体。国内厂商真正要补的,是门槛背后那套收钱的结构。