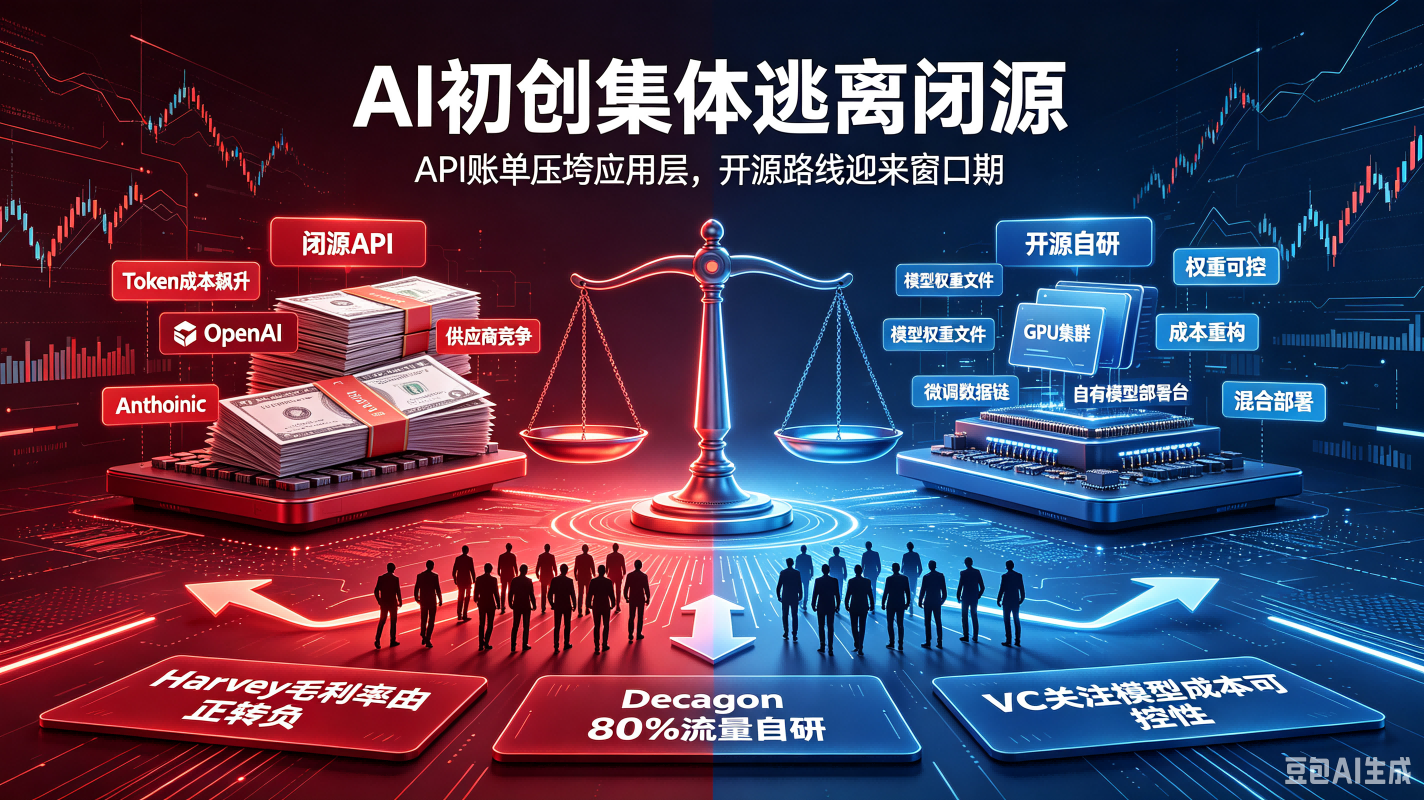
 AI 产业的商业天平,正在从 “调用闭源 API” 向 “持有模型权重” 倾斜。
曾经,绝大多数 AI 创业公司的起步逻辑十分简单:依托 OpenAI、Anthropic 的接口快速落地产品,聚焦场景打磨应用。但如今,持续飙升的 Token 成本、模型厂商同赛道竞争、接口权限不可控三大痛点,正在倒逼一大批垂直 AI 企业重新选择技术底座。
法律 AI 独角兽 Harvey 是本轮行业震荡最典型的样本。这家估值超百亿美元的公司,早期深度绑定闭源大模型,产品落地速度快,一度被视作垂直 AI 标杆。但随着智能体功能上线,Token 消耗呈指数级增长,公司毛利率迅速恶化,从正收益直接跌至负值。 简单来说:产品卖得越多,亏损越严重。 为扭转现金流,Harvey 转向开源底座做自有模型,完成成本重构后,毛利率才重回正向区间。
类似案例正在批量出现:临床 AI 公司 Abridge 基于英伟达开源模型打造垂直医疗大模型;企业客服服务商 Decagon 将八成业务流量迁移至自研模型;Cursor、Ramp 等工具类 AI 企业,也陆续启动模型本地化微调方案。一级市场风向同步转变,不少 VC 已经把 “模型成本可控性” 列为 AI 项目尽调核心指标,纯 API 外包型项目融资难度显著上升。
成本只是表层矛盾,更深层的焦虑来自供应链安全。 第一,高调用量的大客户会面临阶梯加价,大规模智能体场景下,AI 预算很容易超预期。有企业内部曾出现,团队短期高频调用代码模型,直接耗尽年度 AI 预算的情况。 第二,闭源模型厂商持续向垂直行业渗透,推出原生行业方案,和付费 API 客户正面竞争。创业公司投入资源教育市场,最后市场红利可能被上游模型厂商截取。 第三,接口存在不确定性。一旦合作关系生变,模型方有权限制、关停接口,应用产品会直接停摆,供应链完全掌握在别人手中。
对于垂直企业而言,掌握模型权重,本质是拿回算力与数据的自主权。
不过,从闭源 API 切换到开源权重,并不是一条低门槛捷径,行业内已经出现不少自研模型失败的案例。
算力门槛:大权重模型微调、推理部署需要稳定的 GPU 集群,持续算力开销对早期初创并不友好;
人才门槛:模型微调、对齐、推理优化的工程师稀缺,人力成本高昂;
数据门槛:医疗、法律、金融等高合规领域,高质量标注数据稀缺,敏感数据无法直接用于训练。
这也解释了为什么行业没有出现一边倒的替换潮。当下主流最优解是混合部署:常规、高并发的基础业务跑微调后的开源模型,只有高难度、强推理的核心需求,保留调用顶级闭源模型。
上游闭源大厂正站在关键节点:OpenAI、Anthropic 的 IPO 预期,高度依赖 API 收入基本盘。当垂直应用客户持续降低接口依赖,意味着原有商业模式的增长天花板正在显现。
未来一段时间,模型层和应用层的博弈会更加微妙。闭源厂商需要权衡商业化节奏,避免过度挤压应用伙伴的生存空间;而 AI 初创企业,也要理性评估自身资源,在 “外购接口” 和 “自研开源模型” 之间找到适合自己的平衡点。这场路线选择,将直接决定未来一批垂直 AI 公司能不能跨过盈利大关。