OpenAI的硬件版图,又落下一枚关键棋子。
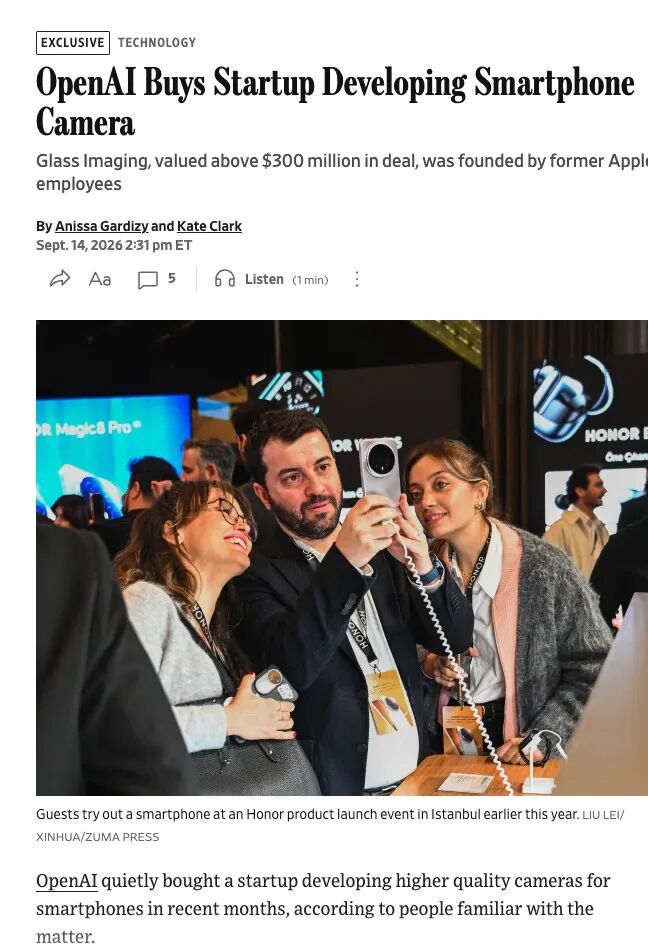
据《华尔街日报》9月18日报道,OpenAI已以超过3亿美元的价格收购相机技术公司Glass Imaging。交易尚未得到OpenAI官方确认,但这家公司的来头值得注意——两位创始人Ziv Attar和Tom Bishop此前都曾在苹果从事计算摄影工作,参与过iPhone人像模式的开发。
去年OpenAI花65亿美元收购了Jony Ive创办的硬件公司io,至今没有拿出让人眼前一亮的产品。现在,工业设计师和相机工程师先后到位,OpenAI的硬件拼图正在补齐最后几块。
Glass Imaging做的事和今天最常见的AI修图完全不是一回事。
手机按下快门后,传感器最先得到的并不是一张可以直接观看的照片,而是一堆原始光信号。传统图像信号处理器需要完成降噪、校色、锐化等工序,才会在屏幕上生成最终图像。每一步由独立算法处理,过程中也会丢掉一部分信息。
Glass Imaging的做法是用一套针对具体镜头和传感器训练的神经网络接管这条流水线。它从传感器的RAW连拍数据出发,把去马赛克、降噪、去模糊、多帧融合放进同一个联合训练的网络,同时加入传统ISP不擅长的镜头像差反卷积和传感器串扰校正,最后直接输出成品图像。
这里的关键区别在于,Glass Imaging的“修复”不是AI修图那种意义上的修。生成式修图可以把远处模糊的文字、月亮和人脸猜得更清晰,但清晰不等于真实。Glass Imaging的资料显示,其网络针对具体光学系统和RAW数据训练,目标是恢复传感器实际捕捉到的信息,而不是凭常识和推论生成新的纹理。
对手机厂商来说,这项技术可以让更小的镜头拍出更清晰的照片。但对一家正在制造AI硬件的公司来说,它还有另一层意义:模型看到的世界,首先取决于摄像头交给它什么。
AI设备需要两种观看能力。第一种发生在屏幕以内,AI要看懂用户正在浏览什么,读取哪些本地信息,获得调用不同App的权限。第二种发生在屏幕以外:菜单上的文字、桌上的物品、眼前的道路,无法只靠聊天记录就让AI知道,需要先拍下一张照片,再把照片交给AI。
照片是人观看的终点,却可能只是Agent工作的起点。如果摄像头只是为了拍朋友圈,照片好看即可。可如果图像要交给Agent判断现实并采取行动,那么凭空补出来的物体和文字就可能导致错误操作。这才是OpenAI对Glass Imaging感兴趣的根本原因。
GlassAI的变焦技术已经进入荣耀600系列,说明它至少完成了从模型、手机芯片到量产设备的适配。公司还曾在骁龙8 Elite Gen 5参考设备上展示实时4K视频处理和20倍以上变焦增强。这些能力目前被用来让人把远处拍得更清楚。在未来,当摄像头连接的不是相册,而是一个准备采取行动的Agent,成像的评价标准就会发生变化——照片不只要看起来漂亮,还要尽可能真实、稳定、及时地呈现文字、物体和空间关系。
Glass Imaging揭示的第一种变化,是硬件与软件之间的分工被重新划定。过去,相机厂商先尽量用镜头和传感器解决像差、模糊与噪声,再让ISP修饰最终图像。GlassAI则允许硬件保留一些能够被计算逆转的缺陷,只要传感器还捕捉到了足够的信息,专门训练的网络便可以在成像过程中将其恢复。
镜头因此可以更小,像素可以继续缩小,一部分原本需要增加镜片、厚度和成本才能解决的问题,被转移给了神经网络。未来AI设备的硬件不必被完整设计出来之后,再往里面塞一个模型。镜头、传感器、NPU、内存和模型会从一开始共同设计。传感器负责保留哪些原始信号、神经网络能够修复哪些误差、设备需要多大的本地算力,这些问题都将反过来影响硬件的形状。
同样的逻辑也可能延伸到麦克风、空间传感器和其他感知部件。过去,硬件负责把世界尽量完整地记录下来,软件只在事后处理。未来,硬件只需要捕捉模型能够理解和还原的信息,模型则从一开始参与影响硬件应该怎样观看世界。
模型不负责决定摄像头看什么,却会改变相机必须用多少硬件,才能得到一幅足以被还原和理解的图像。对一家正在打造AI硬件的公司来说,这不是一次普通的收购,而是为Agent进入现实世界补上了最底层的那一环。